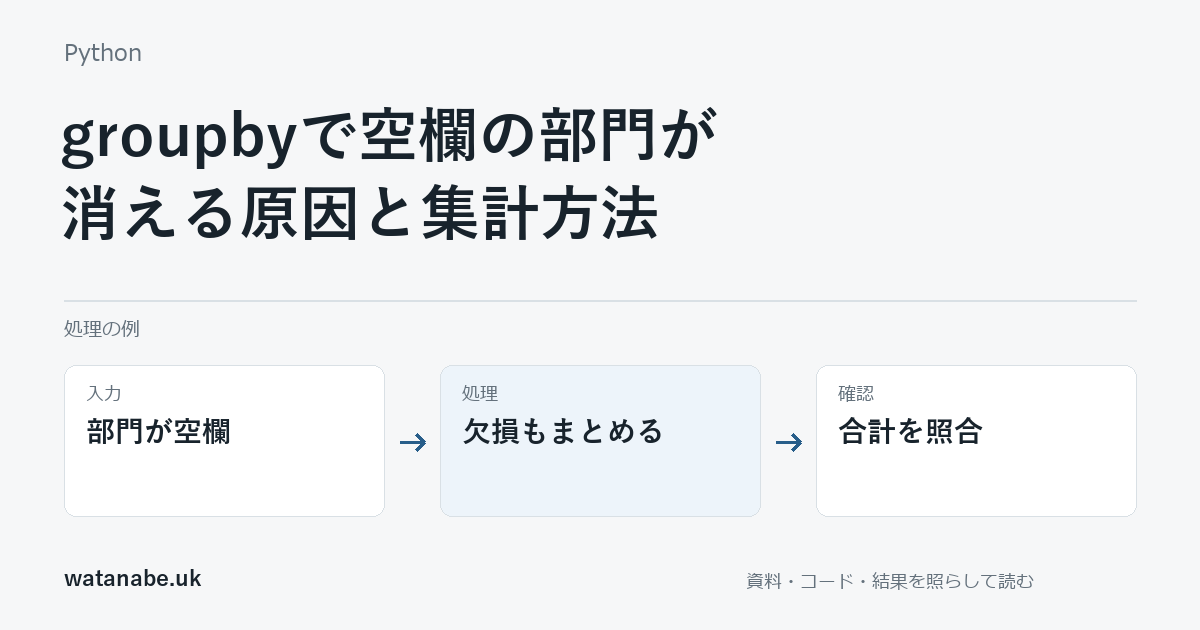
全体の合計は合うのに、部門別の合計を足すと少なくなる。部門名が空欄の行があるなら、groupbyのキーの欠損を確認します。pandasのgroupbyは、既定ではキーが欠損した行をグループへ入れません。
金額列に欠損がなくても、この差は生じます。集計する値の空欄と、分けるための部門名の空欄は別の問題です。部門が未確定の行も全体へ含めるなら、dropna=Falseで欠損のグループを残せます。
欠損グループを残して検算
次の架空データでは、部門Aに100、Bに50、部門未設定に20と30があります。この例では空文字も未設定と決め、欠損へそろえてから集計します。金額はすべて入力済みです。
import pandas as pd

df = pd.DataFrame({
    "部門": pd.Series(["A", None, "B", ""], dtype="string"),
    "金額": [100, 20, 50, 30],
})
df["部門"] = df["部門"].replace("", pd.NA)
default = df.groupby("部門")["金額"].sum()
including_missing = df.groupby("部門", dropna=False)["金額"].sum()
print("既定の部門別合計:", default.sum())
print("欠損を含む合計:", including_missing.sum())
for department, amount in including_missing.items():
    label = "未分類" if pd.isna(department) else department
    print(label, amount)
assert default.sum() == 150
assert including_missing.sum() == df["金額"].sum() == 200
assert including_missing.loc[pd.NA] == 50
既定の部門別合計は150、欠損を含めると200です。未分類の50を残すことで全体と一致します。Windows・Python 3.12.10・pandas 3.0.2で、この四件を使った結果を確認しました。
空文字を欠損へ変えるreplaceは、上の入力条件に合わせた処理です。スペースだけの値や「未設定」という文字も同じとみなすかは、入力元の定義を確かめてから決めます。
未分類は表示用の名前として使う
コード内の「未分類」は結果を読むための表示名です。元の部門列へその文字を一律に保存してはいません。実際に「未分類」という部門名が存在するなら、欠損グループと区別できる列や表示方法を用意します。
分類のない行を見えるようにすることと、正しい部門へ分類し直すことも別です。未分類の件数や金額を確認表に出し、誰がいつ直すかを決める段階へつなげられます。
部門のない行を集計から外すのが正しい業務もあります。その場合も、外した件数と金額が分かるようにすると、総額との差を説明できます。全体と一致しないからといって、欠損を任意の部門名で埋めることはしません。
合計が一致しても元値を見る
この例は金額に欠損や不正値がない前提です。金額の空欄を0とするか、行全体を保留にするかは別に決めます。キーの欠損を含める指定だけで、入力全体の検査を終えたとは判断しません。
複数の列でgroupbyする場合は、どのキーに欠損があるかも確認します。部門と担当者の組で分けるなら、部門はあるが担当者がない行も含まれ得ます。まずはキーを一つにした小さな表で、含まれる行と除かれる行を比べると追いやすくなります。
金額の欠損と検算はCSVの合計・平均を出す方法、表の読み込みはpandas入門で補えます。
参考資料
pandas.DataFrame.groupby公式資料を2026年11月1日に確認しました。